
检测结果
模型:gemini-4-carbon · 模式 quick ·
中转站 https://api.omniakey.com
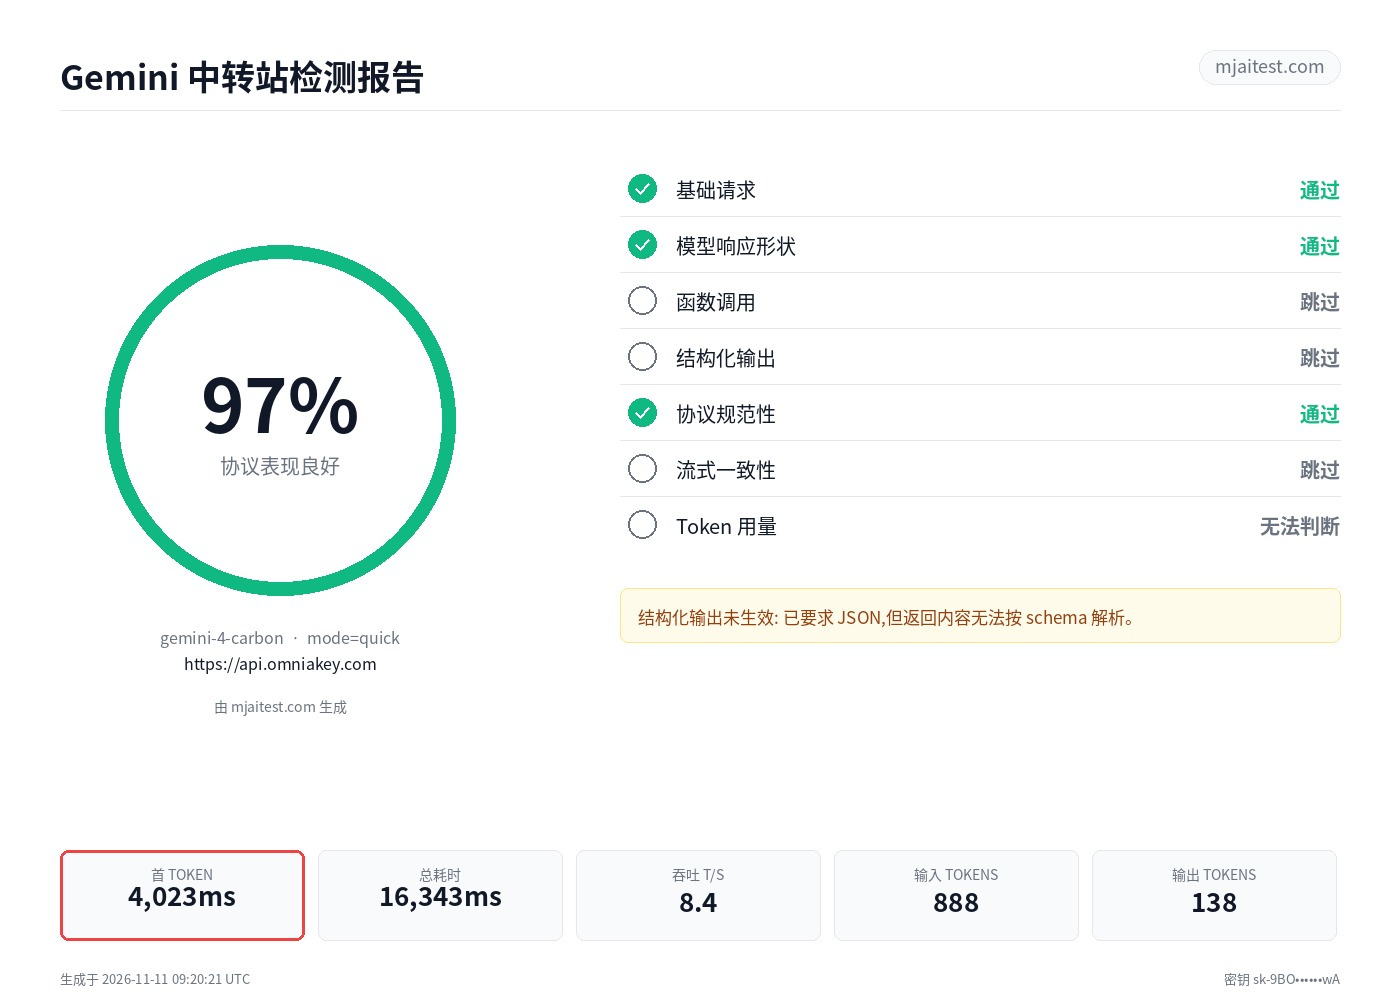
97%
协议表现良好
由 https://www.mjaitest.com 生成
- 基础请求 通过
- 模型响应形状 通过
- 函数调用 跳过
- 结构化输出 跳过
- 协议规范性 通过
- 流式一致性 跳过
- Token 用量 无法判断
这份结果怎么理解?
结构化输出没有真正生效
请求已发送 OpenAI 兼容的 response_format=json_schema strict=true,但 Gemini 中转站返回内容无法按 schema 解析。
Token 用量存在风险
usage 字段不完整或统计不自洽,建议不要直接依赖它做计费核算。
流式响应存在偏差
stream 与 non-stream 的文本、结束原因或 usage 字段没有对齐。
首 TOKEN
4,023ms
总耗时
16,343ms
吞吐 (T/S)
8.4
输入 TOKENS
888
输出 TOKENS
138
Gemini 检测项各自检查什么?
- 基础请求
- 通过 OpenAI 兼容接口发送最小
POST /chat/completions请求,确认能提取文本响应。 - 模型响应形状
- 检查兼容响应中的模型标识、
choices、文本与结束原因等字段。 - 函数调用
- 通过兼容协议请求工具调用,检查
tool_calls的函数名与 arguments JSON。 - 结构化输出
- 使用兼容接口的
response_format=json_schema,检查返回内容能否按 schema 解析。 - 协议规范性
- 检查
id、object、choices、结束原因与usage等 OpenAI 兼容字段;不检测 Gemini 原生协议。 - 流式一致性
- 比较同一 prompt 在
stream:false与stream:true下的文本、结束原因和用量字段。 - Token 用量
- 检查兼容响应的
usage是否存在、Token 统计是否自洽,以及长短文本带来的 Token 增量是否合理。